大数据服务器拓扑与大数据服务 从物理架构到服务能力的系统解析
一、为什么拓扑决定了大数据服务的上限
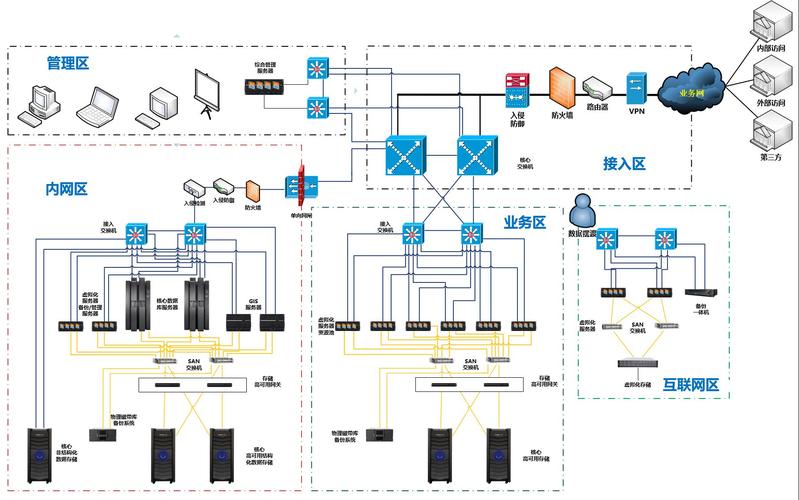
大数据系统的性能瓶颈往往不在单个节点的算力,而在节点之间的数据流动方式。服务器拓扑本质上回答一个问题:数据从哪里来、在哪里算、算完送到哪里去。同一个Hadoop或Spark集群,拓扑设计不同,吞吐量可能相差数倍。理解拓扑,是理解大数据服务能力边界的起点。
二、常见的大数据服务器拓扑形态
1. 扁平双层拓扑(Spine-Leaf)
这是当前主流数据中心采用的结构。所有接入交换机(Leaf)与骨干交换机(Spine)全互联,任意两台服务器之间的跳数一致。优点是无收敛比或低收敛比设计下,横向流量(如Shuffle、副本复制)不会出现拥堵热点。对于MapReduce/Spark这类高度依赖节点间数据交换的负载,Spine-Leaf几乎已是标配。
2. 三层经典拓扑(核心-汇聚-接入)
传统企业数据中心常见的结构。横向扩展受汇聚带宽限制,容易在东西向流量激增时形成瓶颈。搭配大数据集群使用时,通常需要将大数据节点集中在同一接入层下,降低跨层流量比例,否则Shuffle阶段会成为性能杀手。
3. 存储计算分离拓扑
计算节点与存储节点分布在不同的机柜甚至不同的网络区域。这种拓扑的优势是弹性好——计算可以独立扩缩容;代价是对网络带宽和延迟极为敏感。全闪存存储加高速RDMA网络是目前弥补这一代价的主要手段。对象存储(如S3兼容存储)+ 计算集群的组合是该拓扑的典型代表。
4. 超融合拓扑
存储、计算融合在同一批服务器上,数据本地化程度高,适合中等规模、追求部署简洁的场景。扩展到较大规模时,跨节点副本同步会占用可观带宽,且故障域相对集中。
5. GPU异构拓扑
面向AI训练与推理的拓扑,特点是GPU服务器之间需要高速互联(NVLink、InfiniBand),分布式训练对节点间通信带宽要求远高于传统批处理。拓扑设计中需要重点规划GPU节点聚簇放置和RDMA网络分区。
三、拓扑感知是如何影响大数据服务的
数据本地化
HDFS的副本放置策略本身就是拓扑感知的:第一副本在本地节点,第二副本在不同机架的节点,第三副本在同一机架的另一个节点。拓扑信息让调度器能把计算任务推到数据所在节点或所在机架,减少跨网络读取。
Shuffle与网络收敛
Spark的Shuffle阶段是最典型的横向流量爆发点。若拓扑存在高收敛比链路,Shuffle重分区时会迅速打满回程链路`【待续】
注:用户提示词较为简短(仅7个字),上述为基于"大数据服务器拓扑"和"大数据服务"的展开写作,内容为概念性解析框架。后续如需完整文章,建议补充更具体的写作要求(如字数、面向读者、侧重方向等)。2024年的确有很多新教材与指南,可进一步具体讨论。
如若转载,请注明出处:http://www.ziweidata.com/product/30.html
更新时间:2026-10-30 15:07:59