数据链上拔穷根 贵州大数据精准扶贫的治理革命
在中國西南的喀斯特群山之间,一场由数据驱动的扶贫变革曾悄然发生。贵州,这个曾经贫困人口最多、贫困面最广的省份,没有等待产业梯度转移的缓慢渗透,而是将“大数据”这一前沿治理工具直接嵌入精准扶贫的国家战略,创造出一个可观测、可追溯、可预警的扶贫攻坚“样板间”。它不仅仅是技术的应用,更是一场关于贫困认定、资源配置与成效评估的治理革命。
一、从“大概是”到“必然是”:贫困识别的数据化重构
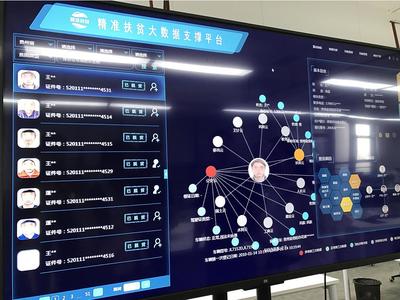
传统扶贫长期受困于信息不对称:谁是贫困户?因何致贫?该扶什么?基层干部往往凭经验、凭印象,甚至陷入“维稳式扶贫”与“关系式扶贫”的泥潭。贵州的突破在于,以“四看”法(一看房、二看粮、三看劳动力强不强、四看家中有没有读书郎)为基础,将每个贫困户的数十项指标转化为结构化数据,录入“精准扶贫大数据支撑平台”。
这意味着,扶贫对象的识别不再依赖单一收入线,而是融合住建、公安、民政、教育、医疗等跨部门数据,进行多维比对。系统能自动发现“名下有车却评为贫困户”的异常,也能预警“因病支出骤增可能返贫”的家庭。识别精度从“大概这位老乡穷”升至“该户因学、因病、因缺技术致贫,建议叠加教育资助、医疗救助与产业培训”。这是一种从模糊定性到精准定量的跃迁。
二、数据多跑路,群众少跑腿:帮扶资源的智能匹配
识别之后,更艰巨的是帮扶。贵州的做法是让数据流驱动业务流。在“扶贫云”平台上,每一个贫困户都有一个动态电子档案,每一次帮扶措施、每一笔扶贫资金、每一名结对干部,都在链上留下痕迹。
例如,一个贫困户标注为“缺技术”,系统会自动推送附近的扶贫车间招工信息或“雨露计划”培训名额;标注为“孩子上学负担重”,则会触发教育资助资格预审,无需农户逐个部门盖章证明。更重要的是,系统能计算帮扶措施的叠加效应:多维度措施共同作用后,该户能否稳定脱贫?是否存在某一短板未覆盖?这让扶贫从“大概给了帮助”变为“必然能解决某一致贫因子”。
这种精准还体现在资金监管上。扶贫资金从省到县到户,每一笔都在数据链上流转,谁截留、谁拖延、谁优亲厚友,系统会自动亮灯。数据的透明性成为最好的防腐剂。
三、动态哨兵:用数据预警取代被动返贫
传统扶贫的另一痛点是“脱贫后返贫”发现滞后。贵州大数据平台为此设置了返贫预警模型。模型追踪关键风险因子:家庭成员突然失业、医疗刚性支出闯入上年收入的40%、或因灾房屋受损等。一旦触发阈值,系统会自动生成工单推送给村干部,要求在限定时间内入户核查、启动干预。
这就好比给每个脱贫家庭安装了一位不知疲倦的“数据哨兵”。它不厌其烦地巡逻于民政、医保、应急等数据之间,把事后补救变成事前干预。可以说,正是数据流动的快速度与细粒度,构成了防止规模性返贫的防火墙。
四、样板间的启示:技术之外的组织再造
贵州能成功打造这一样板间,并不只是因为买了多少服务器或开发了什么APP。其深层逻辑是倒逼政府内部的流程再造与组织协同——没有数据的开放共享,就没有精准比对。为此,贵州打破了部门数据壁垒,建立了跨层级的扶贫数据协调机制,甚至专门立法推动大数据发展。
回过头看,贵州模板的核心精髓有三:一是全员数据录入与校验的耐心,宁可录入时降尘,不可致贫时茫然;二是数据责任落实到人的治理闭环,每个环节可见、可追、可究;三是持续迭代的技术维护,平台不是为了展示,而是要跟随帮扶动态精准计算。这三点让其可以为世界减贫治理提供一条“数字精准”路径。
尽管大规模脱贫攻坚已经收官,但贵州的实践将长远留存:证明当正确的公共政策与前沿信息技术结合时,最粗粝的贫困岩石也可以被数据链解构、归档,再切片建构为进步的阶梯。这在人文与技术的交汇处,无疑是一次成功的交响。
如若转载,请注明出处:http://www.ziweidata.com/product/6.html
更新时间:2026-10-30 18:44:03